Trend topics


Bancaforte TV
Horvath (Gibson Dunn): «L'AI deve creare un audit trail»
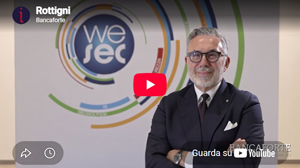
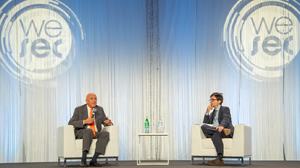
L'intelligenza artificiale mette sotto pressione alcuni dei principi su cui si è costruita la disciplina della privacy. Il diritto di conoscere quali dati vengono detenuti, correggerli o chiederne la cancellazione funziona bene nei sistemi tradizionali. Diventa molto più difficile quando quei dati sono stati utilizzati per addestrare un modello, che non li conserva semplicemente in un archivio ma li incorpora nel proprio apprendimento. È uno dei nodi affrontati da Jane Horvath, Partner di Gibson Dunn, nella videointervista rilasciata a Bancaforte a WeSec – Il Salone della Sicurezza, dove ha partecipato alla tavola rotonda di apertura "Governing the Digital Realm", dedicata anche al difficile equilibrio tra innovazione e regolamentazione. «Come si gestiscono quelli che chiamiamo user rights in un sistema di AI?», si chiede Horvath. È una questione destinata a pesare sempre di più, perché i diritti di accesso, rettifica e cancellazione sono presenti nelle normative sulla privacy, mentre i modelli di intelligenza artificiale funzionano secondo logiche molto diverse da quelle del software tradizionale. Il problema, però, non si risolve semplicemente limitando i dati utilizzati per l'addestramento. Horvath richiama anche una specificità europea: la presenza di molte lingue. Se i modelli non vengono addestrati su quantità sufficienti di dati rappresentativi, la qualità degli output peggiora. Sulla regolamentazione Horvath parte da un paradosso. Tutti chiedono regole per l'AI, ma «nel momento in cui qualcuno mette nero su bianco una regola, tutti dicono che non ha senso, che non funziona». La domanda che pone è se abbia ancora senso tentare di costruire una regolamentazione generale e onnicomprensiva dell'intelligenza artificiale, sul modello di quanto avvenuto con la privacy. Per i dati personali è stato possibile definire alcuni principi trasversali sull'uso, la raccolta e i diritti degli interessati. L'AI, invece, comprende tecnologie e architetture molto differenti: modelli aperti, sistemi chiusi, applicazioni e livelli di rischio che cambiano rapidamente. Da qui l'ipotesi di tornare a un'impostazione più vicina al rischio effettivo e alla tipologia di sistema utilizzato. «Dovremmo ripartire da zero e regolamentare in base al rischio e ai diversi tipi di sistemi AI?», domanda Horvath, mettendo in discussione l'efficacia di un'unica disciplina pensata per coprire un fenomeno in continua evoluzione. Per le banche il tema diventa ancora più concreto. Le decisioni automatizzate possono incidere su transazioni, pagamenti e rapporti finanziari particolarmente sensibili. Per questo, secondo Horvath, gli istituti dovranno essere molto trasparenti e consapevoli delle decisioni prese dai sistemi di AI. «La supervisione umana suona benissimo, ma come può una persona esaminare migliaia di decisioni?», osserva Horvath. Serve invece la possibilità di ricostruire ciò che è accaduto. Horvath richiama le tecnologie che consentono di creare record verificabili delle decisioni dell'AI, vincolando i sistemi a determinate policy e regole. Chi controlla, spiega, deve poter esaminare quella traccia e avere il potere di farlo: non ricontrollare ogni singola decisione, ma vedere come il sistema è arrivato a un risultato e se ha rispettato i vincoli previsti. Per questo, conclude, «l'AI deve creare un audit trail».

WeSec supera le attese: oltre 2.000 visitatori. Tiani (ABI): «Appuntamento nella tarda primavera 2027»

Ferioli (Intesa Sanpaolo): «L'attore ostile è già integrato». A Napoli nasce il Global Defense Center

AI, l'80% delle imprese la adotta ma solo il 9% ne controlla gli utilizzi. Battelli (Deloitte): banche le più mature


Guerra ibrida, le infrastrutture sono il fronte interno. Molinari (ABI ATLAS): «Difenderle è sicurezza nazionale»

Rigoni (Altirium): «Per la sicurezza non basta la consapevolezza: servono strumenti per decidere sotto pressione»


Burlando (BANCOMAT): «Il 70% delle transazioni europee passa su reti globali private. Serve più sovranità digitale»


De Vita (Intesa Sanpaolo): «La sicurezza deve entrare nei processi della banca a monte, non a valle»